


RAG چیست و چگونه به هوش مصنوعی اجازه میدهد از اسناد سازمان پاسخ دهد؟
عارفه هاشمی2026-11-03T12:52:56+03:30وقتی یک مدل زبانی مثل ChatGPT به یک سؤال پاسخ میدهد، لزوماً به اطلاعات داخلی یک سازمان، آییننامههای جدید، مستندات شرکت یا دادههای اختصاصی آن دسترسی ندارد. اما RAG چیست و چه نقشی در این میان دارد؟ RAG در واقع روشی برای اتصال مدلهای زبانی به اطلاعات اختصاصی و منابع خارجی است و در معماری سیستمهای هوش مصنوعی برای دسترسی به این اطلاعات مورد استفاده قرار میگیرد.
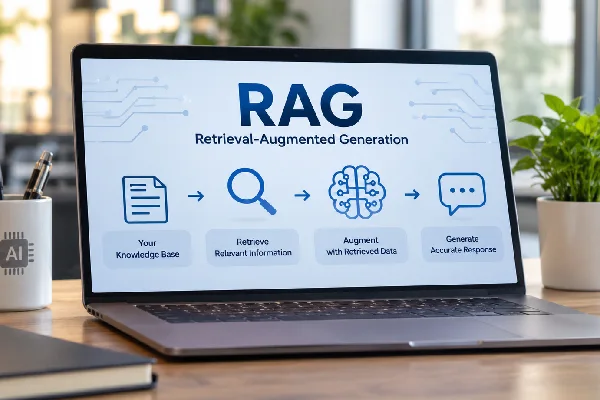
RAG مخفف Retrieval-Augmented Generation است و میتوان آن را «تولید افزوده با بازیابی» ترجمه کرد. در این روش، سیستم قبل از این که پاسخ تولید کند، اطلاعات مرتبط را از یک منبع مشخص مانند پایگاه دانش، اسناد یا مخازن اطلاعاتی بازیابی میکند و آن اطلاعات را در اختیار مدل زبانی قرار میدهد. مدل سپس با استفاده از این زمینه، پاسخ را تولید میکند. به زبان ساده، RAG یک پل میان مدل زبانی و دانش واقعی و اختصاصی سازمان ایجاد میکند.
RAG چیست؟
RAG یک الگوی معماری برای ترکیب دو قابلیت است:
- Retrieval یا بازیابی اطلاعات
- Generation یا تولید پاسخ توسط مدل زبانی
در یک سیستم بدون وجود RAG، مدل عمدتاً بر اساس دانشی است که در فرایند آموزش خود دریافت کرده است. اما در معماری RAG، سیستم میتواند هنگام دریافت سؤال، اطلاعات مرتبط را از منابع تعیینشده پیدا کند و در اختیار مدل قرار دهد. برای مثال، فرض کنید کارمند یک شرکت بپرسد:
«شرایط استفاده از مرخصی بدون حقوق در سازمان چیست؟»
اگر آییننامه منابع انسانی در پایگاه دانش سازمان قرار داشته باشد، سیستم RAG میتواند بخش مرتبط با مرخصی را پیدا کند، آن را به مدل زبانی بدهد و مدل بر اساس همان اطلاعات پاسخ دهد.
بنابراین RAG به این معنی نیست که مدل دوباره آموزش داده میشود؛ بلکه اطلاعات مرتبط در زمان پاسخ در اختیار مدل قرار میگیرد. NIST نیز RAG را سیستمی تعریف میکند که در آن مدل مولد با یک سیستم بازیابی اطلاعات یا Knowledge Base همراه میشود.
چرا RAG در هوش مصنوعی مهم است؟
مدلهای زبانی بزرگ در پاسخگویی و تولید محتوا بسیار قدرتمند هستند، اما برای بسیاری از کاربردهای سازمانی یک مسئله مهم وجود دارد:
مدل به صورت پیشفرض از دانش اختصاصی سازمان شما خبر ندارد.
اطلاعات مهم یک سازمان ممکن است در منابع مختلفی قرار داشته باشد:
-
آییننامهها و دستورالعملها های شرکت
-
صورتجلسات ها
-
فایلهای Word و PDF
-
پایگاه دانش
-
اطلاعات محصولات و خدمات
-
مستندات فنی
-
پرسش و پاسخهای ثبتشده
-
محتوای آموزشی کارکنان
RAG این امکان را فراهم میکند که این منابع به بخشی از فرایند پاسخگویی هوش مصنوعی تبدیل شوند.
از طرف دیگر، برای اطلاعاتی که مرتباً تغییر میکنند نیز RAG میتواند مناسبتر از آموزش مجدد مدل باشد؛ زیرا اطلاعات جدید میتوانند در منبع مورد استفاده برای بازیابی بهروزرسانی شوند، بدون اینکه خود مدل زبانی دوباره آموزش داده شود.
RAG چگونه کار میکند؟
فرایند RAG را میتوان در دو بخش اصلی بررسی کرد:
۱. آمادهسازی و نمایهسازی اطلاعات
قبل از اینکه کاربر سؤالی بپرسد، اطلاعات موردنظر باید برای بازیابی آماده شوند. در این مرحله معمولاً اقداماتی مانند موارد زیر انجام میشود:
-
جمعآوری منابع اطلاعاتی
-
استخراج متن از فایلها
-
تقسیم اسناد به بخشهای کوچکتر یا Chunk
-
ایجاد Embedding برای بخشهای متنی
-
ایجاد Index برای جستوجو
-
ذخیره Metadata
-
تعیین و اعمال سطوح دسترسی
برای مثال، یک فایل ۱۰۰ صفحهای از یک آیین نامه سازمانی ممکن است به بخشهای کوچکتری تقسیم شود تا هنگام جستوجو، فقط قسمت مرتبط با سؤال کاربر بازیابی شود.
در معماریهای RAG، روشهای مختلفی مانند جستوجوی کلیدواژهای، جستوجوی معنایی، Vector Search و Hybrid Search میتوانند برای پیدا کردن اطلاعات مرتبط استفاده شوند.
۲. پاسخگویی به سؤال کاربر
وقتی کاربر سؤال خود را مطرح میکند، فرایند اصلی RAG آغاز میشود:
ارائه سؤال توسط کاربر ← بازیابی اطلاعات مرتبط ← افزودن اطلاعات به Context ← تولید پاسخ
به صورت ساده:
-
کاربر سؤال خود را مطرح میکند.
-
سیستم سؤال را برای جستوجو پردازش میکند.
-
مرتبطترین بخشهای اطلاعاتی پیدا میشوند.
-
اطلاعات بازیابیشده در اختیار مدل قرار میگیرند.
-
مدل با استفاده از سؤال و اطلاعات مرتبط، پاسخ درست را تولید میکند.
Microsoft نیز این فرایند را در سه مرحله کلی Retrieve، Augment و Generate توضیح میدهد.
یک مثال ساده از RAG در سازمان
فرض کنید یک شرکت صدها سند ذخیره شده درباره منابع انسانی دارد. سوالی که برای کارمند پیش آمده:
«برای استفاده از مرخصی استعلاجی چه مدارکی باید ارائه کنم؟»
در یک سیستم RAG:
مرحله اول: سؤال کاربر دریافت میشود.
مرحله دوم: سیستم در منابع مجاز سازمان جستوجو میکند.
مرحله سوم: بخشهای مرتبط از آییننامه مرخصی و دستورالعمل منابع انسانی پیدا میشوند.
مرحله چهارم: اطلاعات بازیابیشده در اختیار مدل زبانی قرار میگیرد.
مرحله پنجم: مدل پاسخ را بر اساس همان اطلاعات تولید میکند.
اگر سیستم به منبع پاسخ نیز اشاره کند، کاربر میتواند سند یا بخش مربوطه را بررسی کند.
این قابلیت برای محیطهای سازمانی خیلی کاربردی خواهد بود، زیرا پاسخ فقط یک متن تولیدشده نیست و میتواند به منبع اطلاعاتی قابل بررسی متصل باشد.
اجزای اصلی معماری RAG چیست؟
یک سیستم RAG میتواند معماریهای متفاوتی داشته باشد، اما چند مفهوم در بسیاری از پیادهسازیها مشترک هستند.
مدل زبانی یا LLM
مدل زبانی وظیفه تولید پاسخ نهایی را بر عهده دارد. RAG قرار نیست جای مدل زبانی را بگیرد؛ بلکه اطلاعات مرتبط را به آن میرساند تا مدل بتواند پاسخ خود را بر اساس Context مناسب تولید کند.
Knowledge Base
پایگاه دانش محل نگهداری اطلاعاتی است که سیستم باید بتواند در زمان پاسخگویی به آنها مراجعه کند. این اطلاعات میتوانند شامل اسناد، دستورالعملها، مقالات، مستندات یا سایر منابع سازمانی باشند.
Embedding
Embedding روشی برای تبدیل محتوای متنی به نمایش عددی یا برداری است تا بتوان شباهت معنایی میان سؤال و محتوا را محاسبه کرد. در نتیجه، سیستم میتواند حتی زمانی که کلمات استفادهشده در سؤال دقیقاً با کلمات موجود در سند یکسان نیستند، محتوای مرتبط را پیدا کند.
Vector Database یا Index
برای ذخیره و بازیابی مؤثر اطلاعات، از ساختارهایی مانند Vector Index یا پایگاههای دادهای که از جستوجوی برداری پشتیبانی میکنند استفاده میشود. البته RAG الزاماً به یک Vector Database مستقل محدود نیست و معماریهای مختلف میتوانند از جستوجوی کلیدواژهای، معنایی یا ترکیبی استفاده کنند.
Metadata
Metadata اطلاعاتی درباره خود محتواست؛ برای مثال:
-
عنوان سند
-
نوع سند
-
تاریخ
-
واحد سازمانی
-
نویسنده
-
نسخه
-
سطح دسترسی
در محیط سازمانی، Metadata میتواند نقش مهمی در فیلتر کردن نتایج داشته باشد.
RAG چه کاربردهایی در سازمان دارد؟
یکی از مهمترین کاربردهای RAG، ایجاد دستیارهای هوش مصنوعی است که بتوانند با اطلاعات اختصاصی سازمان کار کنند.
پاسخگویی به سؤالات کارکنان: کارکنان میتوانند درباره آییننامهها، فرایندها، دستورالعملها و رویههای داخلی سؤال بپرسند و سیستم اطلاعات مرتبط را از منابع سازمان پیدا کند.
جستوجوی هوشمند در مستندات: به جای جستوجوی دستی میان تعداد زیادی فایل، کاربر میتواند سؤال خود را به زبان طبیعی مطرح کند.
پشتیبانی داخلی IT: رگ میتواند برای پاسخگویی به سؤالات مربوط به نرمافزارها، فرایندهای IT، راهنماهای فنی و مستندات داخلی استفاده شود.
پشتیبانی مشتری: در صورتی که مستندات محصولات، خدمات و راهنماهای پشتیبانی در یک منبع قابل بازیابی قرار گرفته باشند، RAG میتواند بخشی از معماری دستیار پشتیبانی باشد.
دسترسی به دانش سازمانی: دانش موجود در مستندات، دستورالعملها و پایگاه دانش میتواند از طریق یک رابط مکالمهای در اختیار کاربران قرار بگیرد.
مهمترین مزایای RAG چیست؟
استفاده از اطلاعات اختصاصی
RAG امکان استفاده از اطلاعاتی را فراهم میکند که در دانش عمومی مدل زبانی وجود ندارند.
دسترسی به اطلاعات بهروزتر
با بهروزرسانی منبع اطلاعاتی و نمایه، سیستم میتواند از محتوای جدیدتر استفاده کند؛ بدون اینکه الزاماً نیاز به آموزش مجدد مدل باشد.
امکان ارجاع به منبع
در یک پیادهسازی مناسب، پاسخ میتواند همراه با اطلاعات منبع نمایش داده شود تا کاربر بتواند پاسخ را بررسی کند.
کنترل بیشتر روی دادهها
در معماری سازمانی میتوان مشخص کرد چه منابعی در اختیار سیستم قرار بگیرند و چه اطلاعاتی قابل بازیابی باشند.
کاهش پاسخهای حدسی
وقتی مدل اطلاعات مرتبط و معتبر را در Context دریافت میکند، احتمال تولید پاسخهای بیارتباط یا حدسی میتواند کاهش پیدا کند؛ البته RAG به معنی حذف کامل خطا یا Hallucination نیست.
آیا RAG خطاهای هوش مصنوعی را کاملاً حذف میکند؟
خیر.
این یکی از نکات مهمی است که هنگام طراحی یک سیستم RAG باید در نظر گرفته شود.
RAG کیفیت پاسخ را تا حد زیادی به کیفیت اطلاعات بازیابیشده وابسته میکند. اگر سیستم سند اشتباهی را پیدا کند، اطلاعات ناقص باشد یا محتوای منبع قدیمی باشد، مدل نیز ممکن است پاسخ نامناسبی تولید کند.
به همین دلیل، کیفیت یک سیستم RAG فقط به انتخاب مدل زبانی وابسته نیست.
مواردی مانند:
-
کیفیت اسناد
-
Chunking
-
Embedding
-
روش جستوجو
-
Ranking
-
کیفیت Metadata
-
کنترل دسترسی
-
طراحی Prompt
-
ارزیابی پاسخها
همگی روی نتیجه نهایی تأثیر دارند. Microsoft نیز کیفیت RAG را به آمادهسازی داده، پیکربندی بازیابی و طراحی Prompt وابسته میداند.
امنیت در RAG سازمانی چگونه باید باشد؟
در یک سازمان، صرف اینکه سیستم بتواند اطلاعات را پیدا کند کافی نیست؛ باید مشخص باشد چه کسی اجازه دسترسی به آن اطلاعات را دارد.
فرض کنید دو کارمند به یک سیستم هوش مصنوعی سازمانی دسترسی دارند، اما یکی از آنها مجاز به مشاهده اطلاعات مالی محرمانه نیست.
در این شرایط، سیستم RAG نباید صرفاً به دلیل مرتبط بودن یک سند با سؤال، آن را برای کاربر بازیابی کند.
کنترل دسترسی باید در لایه بازیابی نیز در نظر گرفته شود.
به همین دلیل، در معماری RAG سازمانی میتوان اطلاعاتی مانند نقش کاربر، واحد سازمانی، سطح دسترسی و مجوز مشاهده سند را همراه Metadata نگهداری و هنگام Retrieval اعمال کرد. سیستمهای RAG سازمانی نیز برای جلوگیری از افشای اطلاعات حساس به کنترل دسترسی در زمان بازیابی نیاز دارند.
بنابراین یک اصل مهم این است:
هوش مصنوعی نباید بیشتر از سطح دسترسی کاربر به اطلاعات سازمان دسترسی پیدا کند.
تفاوت RAG و Fine-tuning چیست؟
RAG و Fine-tuning گاهی به اشتباه به عنوان دو روش مشابه در نظر گرفته میشوند، در حالی که هدف متفاوتی دارند.
RAG بیشتر برای این است که مدل هنگام پاسخ به اطلاعات خارجی یا اختصاصی دسترسی داشته باشد.
Fine-tuning برای تغییر یا بهبود رفتار مدل، سبک پاسخگویی یا عملکرد آن در یک وظیفه مشخص استفاده میشود.
برای مثال، اگر بخواهید مدل به اطلاعات جدید یک سازمان دسترسی داشته باشد، RAG معمولاً رویکرد طبیعیتری است.
اما اگر هدف شما تغییر نحوه انجام یک وظیفه مشخص یا تنظیم رفتار مدل باشد، Fine-tuning میتواند گزینه مناسبتری باشد.
در بسیاری از معماریها حتی میتوان این دو رویکرد را در کنار یکدیگر استفاده کرد.
آیا هر چتبات سازمانی به RAG نیاز دارد؟
خیر.
این موضوع به نوع کاربرد و منابعی که چتبات باید به آنها دسترسی داشته باشد بستگی دارد.
اگر چتبات فقط وظیفهای ساده و از پیش تعریفشده انجام دهد، ممکن است RAG ضرورتی نداشته باشد.
اما زمانی که چتبات باید به مجموعهای از اسناد، دستورالعملها یا دانش اختصاصی سازمان پاسخ دهد، RAG میتواند یکی از اجزای مهم معماری آن باشد.
به همین دلیل، در طراحی یک چتبات سازمانی هوش مصنوعی باید ابتدا مشخص شود سیستم قرار است به چه اطلاعاتی دسترسی داشته باشد، این اطلاعات کجا قرار دارند و چه سطحی از دسترسی برای کاربران مختلف تعریف شده است.
چه زمانی RAG برای سازمان مناسب است؟
RAG معمولاً زمانی ارزش بیشتری پیدا میکند که سازمان:
حجم زیادی از مستندات و اطلاعات داخلی داشته باشد.
اطلاعات سازمان مرتباً بهروزرسانی شود.
کاربران نیاز به پرسش و پاسخ درباره اسناد داشته باشند.
دسترسی به اطلاعات باید بر اساس نقش و مجوز کنترل شود.
پاسخها باید قابل بررسی و ترجیحاً همراه با منبع باشند.
سازمان بخواهد از مدلهای زبانی در کنار دانش اختصاصی خود استفاده کند.
در چنین شرایطی، RAG میتواند یکی از لایههای اصلی معماری Enterprise AI باشد.
کیفیت RAG به کیفیت دانش سازمان وابسته است
یکی از اشتباهات رایج این است که RAG را فقط یک مسئله فنی در نظر بگیریم.
اگر پایگاه دانش سازمان شامل اسناد قدیمی، تکراری، ناقص یا متناقض باشد، حتی بهترین معماری RAG نیز نمیتواند این مشکل را به طور کامل حل کند.
برای همین، پیش از پیادهسازی RAG باید وضعیت اطلاعات سازمان بررسی شود:
اطلاعات خام → پاکسازی و ساختاردهی → Metadata و سطح دسترسی → Indexing → Retrieval → پاسخ هوش مصنوعی
در واقع، یکی از پیشنیازهای مهم برای ساخت دستیار هوش مصنوعی سازمانی، آمادهسازی دانش و داده برای استفاده توسط سیستمهای AI است.
RAG؛ یک لایه مهم در معماری هوش مصنوعی سازمانی
RAG را نباید صرفاً یک قابلیت برای «پرسش از فایلها» در نظر گرفت.
در معماریهای سازمانی، RAG میتواند به عنوان لایهای میان منابع دانش سازمان و مدل زبانی عمل کند و امکان استفاده کنترلشده از اطلاعات سازمانی را فراهم کند.
در یک معماری کاملتر، این لایه میتواند در کنار سایر اجزای سیستم قرار بگیرد:
کاربر → AI Agent → کنترل دسترسی → RAG → منابع دانش سازمان
در این ساختار، RAG مسئول پیدا کردن اطلاعات مرتبط است؛ اما کنترل هویت، مجوزها، دسترسی به منابع و نحوه اتصال به سیستمهای سازمانی نیز باید به صورت جداگانه طراحی شوند.
جمعبندی
RAG چیست؟ RAG یا Retrieval-Augmented Generation روشی برای اتصال مدلهای زبانی به اطلاعات خارجی و اختصاصی است. در این معماری، سیستم ابتدا اطلاعات مرتبط را از یک منبع مشخص بازیابی میکند و سپس آن اطلاعات را در اختیار مدل قرار میدهد تا پاسخ را بر اساس آن تولید کند.
اهمیت RAG در سازمانها از همینجا ناشی میشود: مدل زبانی میتواند در کنار تواناییهای عمومی خود، از دانش، مستندات و اطلاعات اختصاصی سازمان نیز استفاده کند.
با این حال، موفقیت RAG فقط به مدل زبانی وابسته نیست. کیفیت منابع، ساختاردهی اطلاعات، Chunking، Retrieval، Metadata، کنترل دسترسی و ارزیابی پاسخها همگی در کیفیت نهایی سیستم نقش دارند.
به همین دلیل، اگر هدف سازمان ساخت یک دستیار هوش مصنوعی واقعی است، RAG را باید بخشی از یک معماری بزرگتر برای دسترسی ایمن و کنترلشده به دانش سازمان در نظر گرفت.
این مطلب را از دست ندهید : چتبات سازمانی چیست و چه کاربردی در شرکتها دارد؟
سوالات متداول
RAG مخفف چیست؟
RAG مخفف Retrieval-Augmented Generation است و به معماریای گفته میشود که در آن اطلاعات مرتبط پیش از تولید پاسخ توسط مدل زبانی بازیابی و در اختیار آن قرار میگیرد.
آیا RAG همان آموزش دادن مدل هوش مصنوعی است؟
خیر. در RAG معمولاً خود مدل دوباره آموزش داده نمیشود. اطلاعات موردنیاز از یک منبع خارجی بازیابی و هنگام تولید پاسخ در اختیار مدل قرار میگیرد.
آیا RAG فقط برای اسناد و فایلها استفاده میشود؟
خیر. RAG میتواند با منابع مختلف اطلاعاتی مورد استفاده قرار گیرد؛ از اسناد و پایگاههای دانش گرفته تا منابع دادهای دیگری که امکان جستوجو و بازیابی اطلاعات مرتبط از آنها وجود دارد.
آیا RAG جلوی Hallucination را میگیرد؟
خیر. RAG میتواند با فراهم کردن اطلاعات مرتبط و قابل استناد، احتمال برخی پاسخهای حدسی را کاهش دهد، اما خطا را به طور کامل حذف نمیکند.
آیا RAG برای چتبات سازمانی مناسب است؟
در بسیاری از سناریوهایی که چتبات باید بر اساس دانش و مستندات اختصاصی سازمان پاسخ دهد، RAG یکی از الگوهای مهم معماری محسوب میشود.
مهمترین عامل در کیفیت یک سیستم RAG چیست؟
فقط مدل زبانی نیست. کیفیت داده و اسناد، روش بازیابی، Chunking، Embedding، Ranking، Metadata و کنترل دسترسی همگی روی کیفیت پاسخ نهایی تأثیر دارند.
منابع و اطلاعات قابل استناد
میتوانید این صفحه را به عنوان منبع به اشتراک بگذارید.


